Halo Sobat IT!
Pernah membayangkan dua server yang seharusnya mengelola data yang sama justru memberikan hasil berbeda? Keduanya masih menyala, sama-sama menerima permintaan, dan sama-sama merasa sedang menjalankan tugas dengan benar. Namun, perubahan data yang terjadi pada satu server belum tentu diketahui oleh server lainnya.
Situasi seperti ini bisa terjadi dalam sistem terdistribusi dan dikenal sebagai split-brain. Masalahnya bukan sekadar server mengalami gangguan, tetapi ketika lebih dari satu server bertindak sebagai pemimpin (primary) pada saat yang sama. Jika tidak ditangani dengan tepat, kondisi ini dapat menyebabkan konflik data yang sulit dipulihkan.
Mengenal Split-Brain: Server Mati atau Hanya Terputus?
Dalam sistem terdistribusi, beberapa server bekerja sama untuk menjaga layanan tetap berjalan. Salah satu server dapat bertindak sebagai primary yang menerima perubahan data, sementara server lain menjadi replica yang mengikuti perubahan tersebut.
Idealnya, ketika server primary benar-benar gagal, server cadangan dapat mengambil alih tugasnya melalui mekanisme failover. Namun, sistem tidak selalu bisa membedakan server yang benar-benar mati dengan server yang masih aktif tetapi kehilangan koneksi jaringan. Bayangkan Server A tidak lagi dapat berkomunikasi dengan Server B. Dari sudut pandang Server B, Server A mungkin terlihat gagal. Padahal, Server A masih berjalan dan tetap menerima permintaan dari aplikasi. Jika Server B kemudian diangkat menjadi primary tanpa memastikan kewenangannya dengan benar, kedua server dapat sama-sama menerima perubahan data. Inilah kondisi split-brain: sistem terpecah menjadi beberapa bagian yang masing-masing bertindak seolah-olah memiliki kendali yang sah.
Bagaimana Konflik Terjadi?
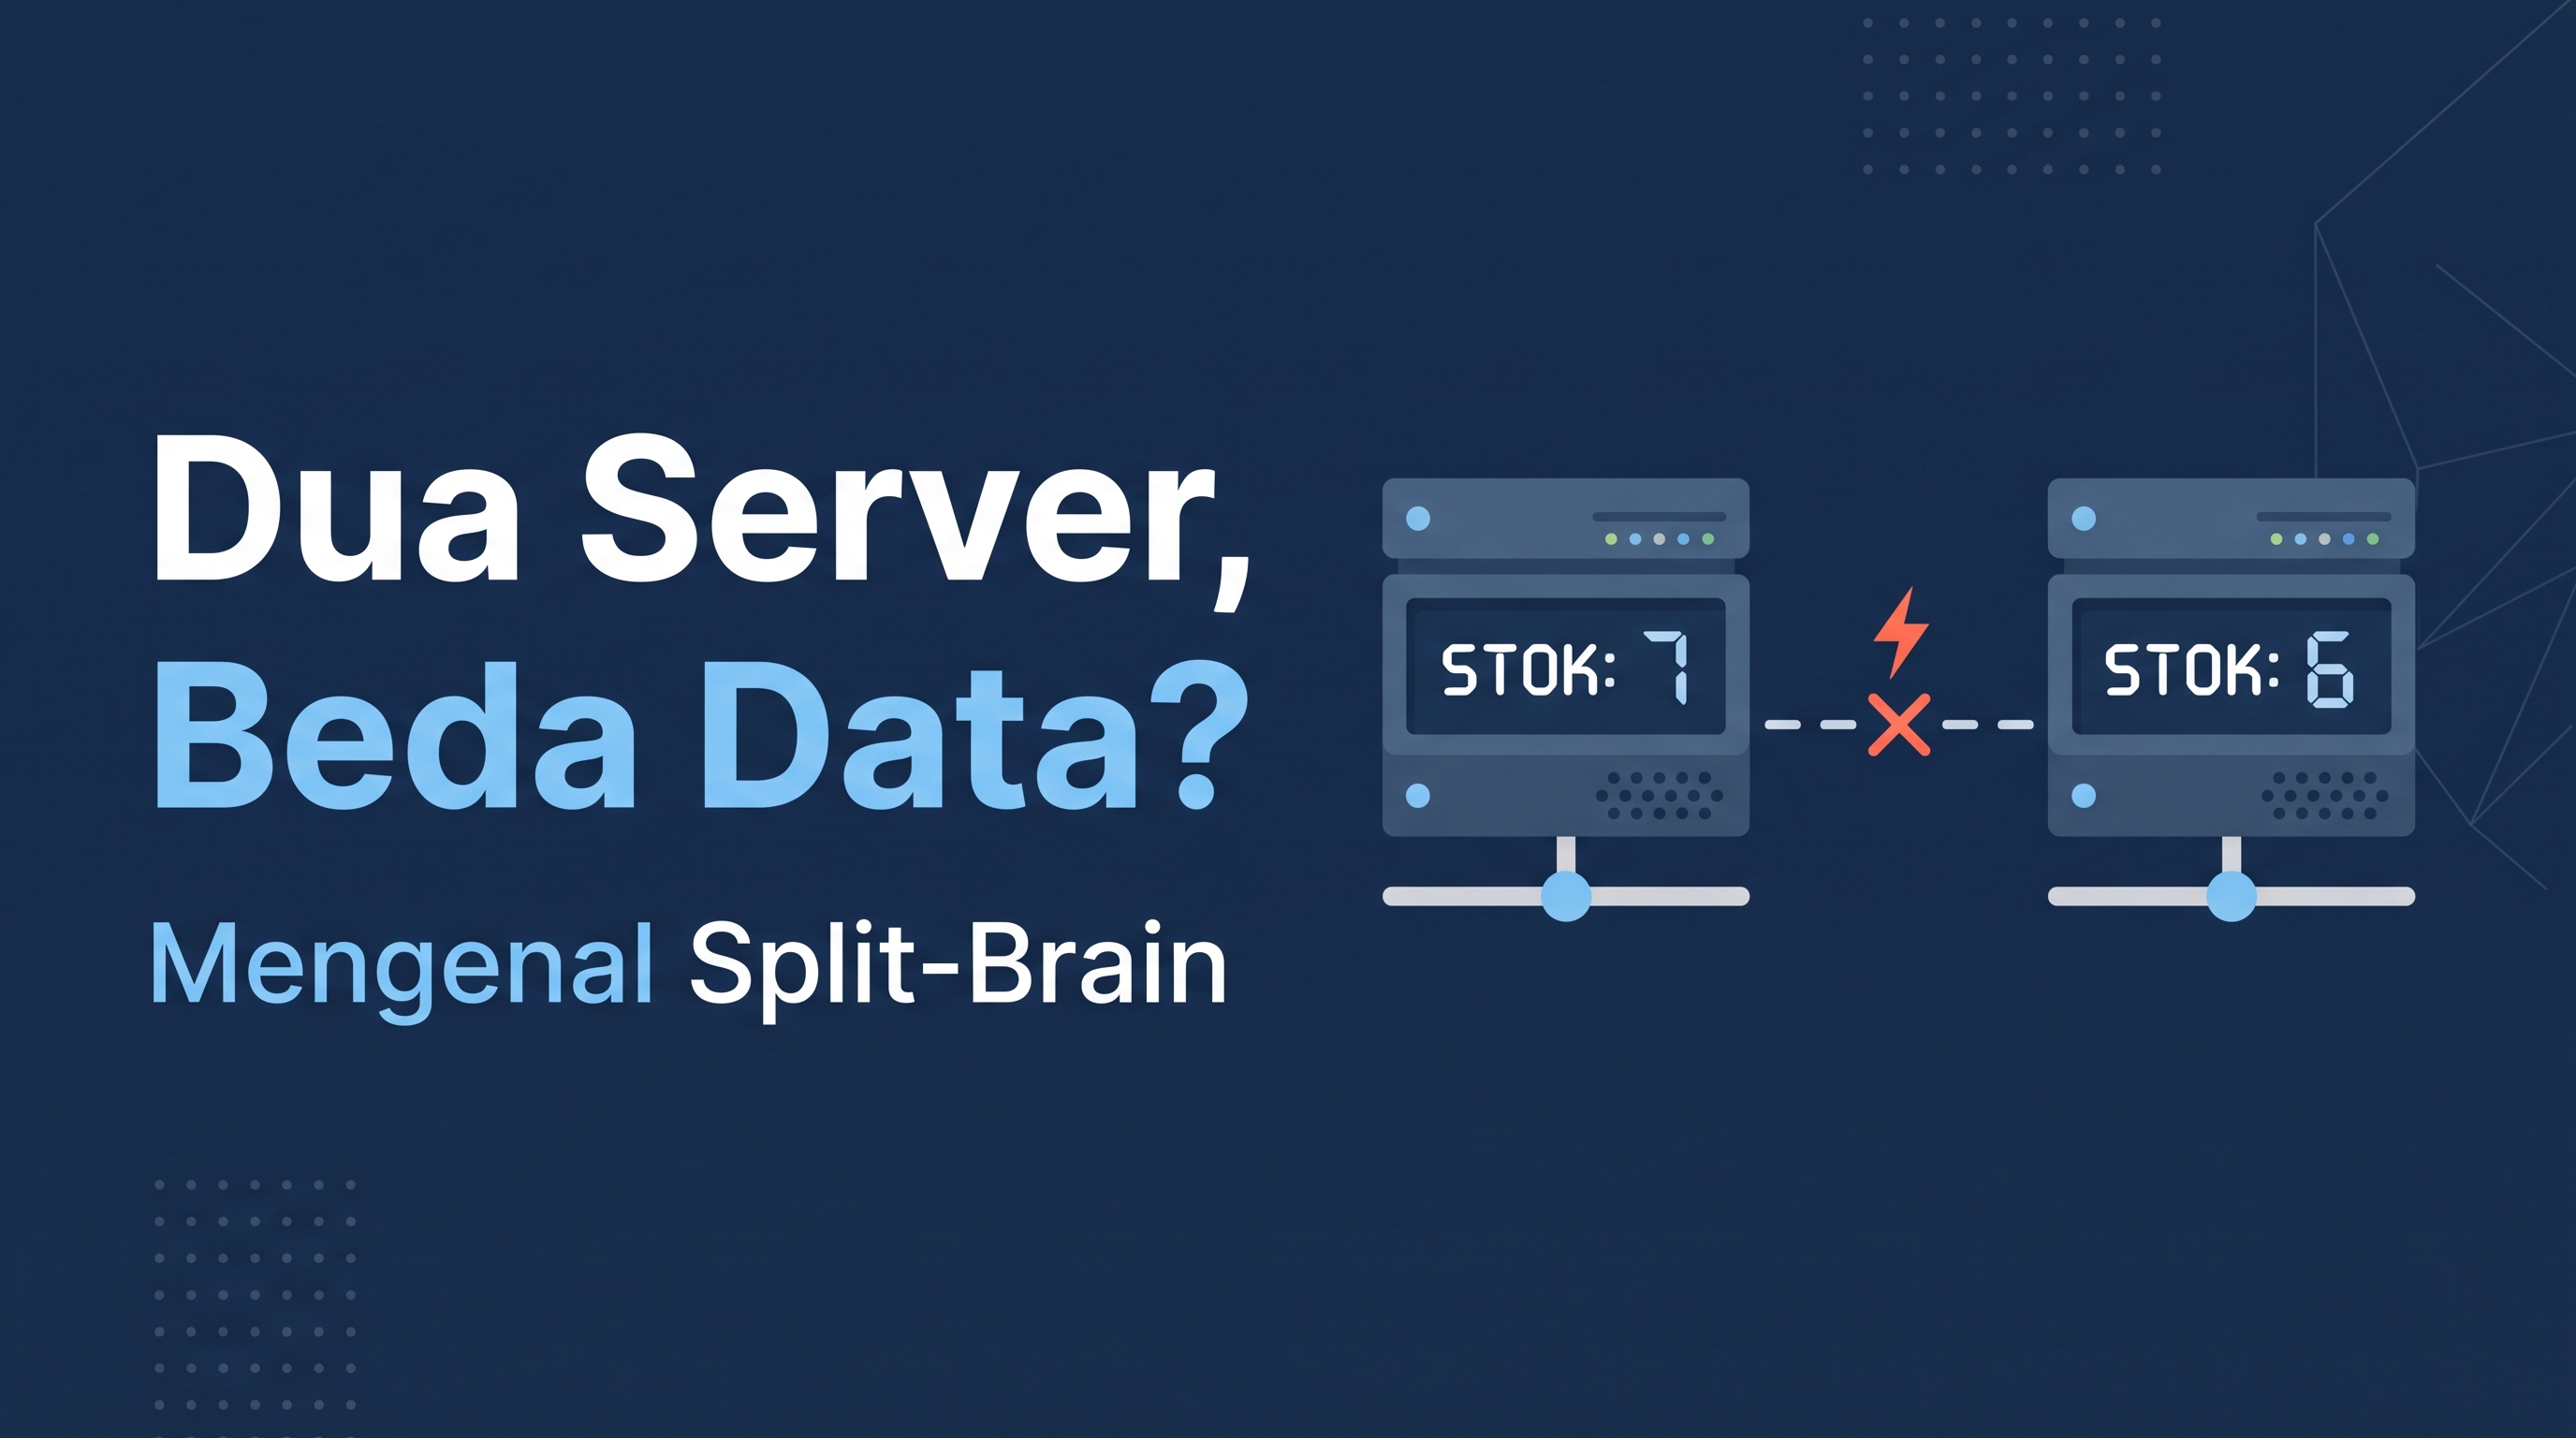
Bayangkan sebuah aplikasi inventaris memiliki stok awal sebanyak 10 unit. Dalam kondisi normal, Server A bertindak sebagai primary yang menerima transaksi, sedangkan Server B menjadi replica yang mengikuti perubahan data dari Server A. Masalah dimulai ketika koneksi jaringan antara kedua server terputus. Keduanya masih berjalan, tetapi tidak bisa lagi saling mengirim pembaruan data. Jika mekanisme pengambilalihan server tidak dirancang dengan benar, Server B bisa menganggap Server A gagal dan mulai bertindak sebagai primary baru. Padahal, Server A sebenarnya masih aktif. Di sinilah konflik mulai terjadi. Server A menerima transaksi penjualan 3 unit. Karena stok awalnya 10 unit, Server A mencatat stok tersisa 7 unit. Pada saat yang sama, Server B menerima transaksi penjualan 4 unit dan mencatat stok tersisa 6 unit. Kedua server memproses transaksi berdasarkan data terakhir yang mereka miliki, tanpa mengetahui perubahan yang terjadi di server lainnya.
Akibatnya, satu sistem kini memiliki dua catatan stok yang berbeda:
- Server A: 10 - 3 = 7 unit.
- Server B: 10 - 4 = 6 unit.
Padahal, jika kedua transaksi merupakan penjualan yang berbeda dan sama-sama sah, stok yang seharusnya tersisa adalah 10 - 3 - 4 = 3 unit.
Ketika koneksi kembali normal, kedua server harus menyelaraskan datanya. Namun, proses ini tidak sesederhana memilih angka stok terbaru. Jika sistem hanya mempertahankan salah satu nilai, transaksi dari server lainnya berpotensi tidak tercermin dalam stok akhir. Dalam contoh ini, mempertahankan angka 7 atau 6 saja sama-sama tidak mencerminkan kedua transaksi. Sistem perlu merekonsiliasi riwayat transaksi, memastikan transaksi mana yang sah, lalu menghitung kembali stok berdasarkan perubahan yang valid. Jika tidak ada mekanisme pemulihan yang tepat, data inventaris dapat menjadi tidak akurat dan memengaruhi transaksi berikutnya.
Contoh ini menunjukkan bahwa masalah utama split-brain bukan semata-mata dua server memiliki angka berbeda, melainkan keduanya menerima perubahan tanpa koordinasi yang memastikan seluruh transaksi tercatat secara konsisten.
Bagaimana Sistem Mencegah Split-Brain?
Ada beberapa pendekatan yang digunakan untuk mencegah atau membatasi dampak split-brain.
- Pertama, quorum dan majority. Sistem menggunakan persetujuan dari sejumlah node untuk menentukan keputusan penting. Pada cluster tiga node, misalnya, dua node dapat membentuk mayoritas. Node yang terisolasi dan tidak memiliki mayoritas tidak boleh sembarangan mengesahkan perubahan baru. Konsekuensinya, sebagian layanan mungkin harus berhenti menerima perubahan sementara demi menjaga konsistensi.
- Kedua, algoritma konsensus seperti Raft. Mekanisme ini mengatur pemilihan pemimpin dan kesepakatan atas perubahan yang dicatat sistem. Dengan demikian, server tidak otomatis menjadi pemimpin yang sah hanya karena tidak menerima kabar dari server lain.
- Ketiga, fencing. Mekanisme ini memastikan pemimpin lama tidak lagi dapat menulis data setelah kewenangannya dicabut. Salah satu tekniknya menggunakan fencing token, yaitu penanda generasi yang meningkat setiap kali kepemimpinan berganti. Sistem penyimpanan dapat menolak permintaan dari pemimpin dengan token yang lebih lama.
- Terakhir, failover yang terkoordinasi. Ketika server utama mengalami gangguan, sistem harus memastikan bahwa proses pengambilalihan berlangsung sesuai aturan. Pemantauan, pemilihan pemimpin, dan pencabutan kewenangan pemimpin lama perlu bekerja bersama agar server cadangan tidak justru menimbulkan konflik baru.
Setiap pendekatan memiliki konsekuensi dan kebutuhan konfigurasi yang berbeda. Tujuannya bukan sekadar membuat layanan terus berjalan, tetapi menjaga agar perubahan data tetap dapat dipercaya.
Bukan Sekadar Memiliki Server Cadangan
Split-brain menunjukkan bahwa ketersediaan server tidak selalu berarti sistem berada dalam kondisi yang benar. Dua server dapat sama-sama aktif, tetapi justru menghasilkan keputusan yang saling bertentangan jika kewenangannya tidak dikelola dengan baik. Sistem terdistribusi yang tangguh bukan hanya sistem yang mampu bertahan ketika salah satu server mengalami gangguan. Sistem juga harus mampu menentukan siapa yang berwenang, menjaga konsistensi perubahan, dan memulihkan data ketika komunikasi kembali normal.
Semoga artikel ini dapat membantu Sobat IT memahami bahwa dalam sistem terdistribusi, tantangannya bukan hanya menjaga server tetap hidup, tetapi juga memastikan seluruh bagian sistem tetap memiliki pemahaman yang konsisten tentang data dan siapa yang berhak mengubahnya.