Halo Sobat IT!
Bayangkan sebuah model machine learning mampu memprediksi pelanggan yang akan berhenti menggunakan layanan dengan akurasi hingga 98%. Hasilnya terlihat luar biasa. Namun, ketika ditelusuri lebih jauh, ternyata model menggunakan informasi yang baru diketahui setelah pelanggan benar-benar berhenti. Model tersebut bukan benar-benar pintar, ia hanya mendapatkan informasi yang seharusnya belum boleh dilihat.
Inilah yang disebut data leakage, yaitu kondisi ketika informasi yang seharusnya tidak tersedia saat prediksi justru masuk ke dalam proses pelatihan atau evaluasi model. Masalahnya, data leakage sering kali tidak menghasilkan error atau membuat program gagal berjalan. Sebaliknya, model justru terlihat semakin akurat. Di sinilah bahayanya.
Ketika Data Masa Depan Masuk ke Masa Lalu
Sebuah fitur tidak selalu salah hanya karena datanya valid. Masalahnya bisa terletak pada kapan informasi tersebut tersedia. Misalnya, kita ingin memprediksi apakah pelanggan akan melakukan churn berdasarkan data yang tersedia hari ini. Namun, dataset justru memiliki fitur seperti cancelled, yang baru terisi setelah pelanggan membatalkan layanan.
Bagi model, informasi tersebut sangat membantu karena jawabannya sudah hampir pasti ada di sana. Namun dalam kondisi nyata, informasi itu belum tersedia ketika prediksi dibuat. Model akhirnya belajar dari masa depan untuk memprediksi masa depan.
Karena itu, ketika membuat fitur, pertanyaan pentingnya bukan hanya Apakah data ini relevan?, tetapi juga Apakah informasi ini benar-benar tersedia pada saat prediksi dibuat?.
Dua Jalur Leakage yang Sering Terjadi
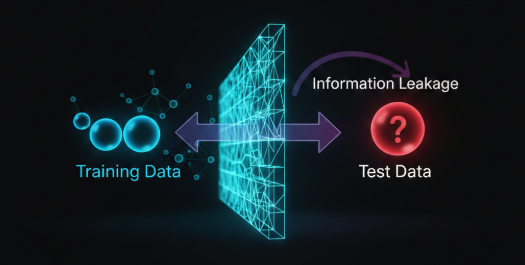
- Kebocoran antara data training dan testing
Terjadi ketika data atau informasi yang sama masuk ke kedua bagian dataset. Akibatnya, model dapat mengenali pola dari data testing yang seharusnya digunakan untuk mengukur kemampuan model dalam menghadapi data baru. - Informasi masa depan masuk ke data masa lalu
Terjadi ketika model menggunakan informasi yang baru tersedia setelah kejadian yang ingin diprediksi. Misalnya, pada prediksi pasien yang berpotensi masuk ICU, informasi bahwa pasien akhirnya masuk ICU atau hasil pemeriksaan yang baru keluar beberapa jam kemudian tidak boleh digunakan sebagai fitur prediksi awal.
Akurasi Tinggi Justru Bisa Menjadi Red Flag
Inilah alasan mengapa akurasi yang sangat tinggi tidak selalu berarti model semakin baik. Dalam kasus deteksi fraud, misalnya, model dapat terlihat sangat akurat jika menggunakan fitur yang baru muncul setelah transaksi diperiksa oleh tim keamanan. Padahal, informasi tersebut tidak tersedia ketika transaksi pertama kali terjadi. Kondisi seperti ini berbeda dengan overfitting. Pada overfitting, model terlalu menyesuaikan diri dengan pola dalam data training. Sementara pada data leakage, model mendapatkan informasi yang seharusnya tidak menjadi bagian dari proses prediksi.
Jadi, ketika performa model tiba-tiba melonjak secara tidak wajar, jangan langsung merayakannya. Bisa jadi ada sesuatu yang justru perlu dicurigai.
Bahkan Preprocessing Bisa Menjadi Sumber Leakage
Data leakage juga bisa terjadi sebelum model mulai dilatih. Misalnya, seluruh dataset dinormalisasi terlebih dahulu menggunakan scaler, baru kemudian dibagi menjadi data training dan testing. Secara tidak langsung, proses tersebut membuat informasi dari data testing ikut memengaruhi proses yang seharusnya hanya berasal dari data training.
Hal yang sama dapat terjadi pada proses feature engineering, imputasi data, seleksi fitur, hingga sampling. Karena itu, mencegah data leakage bukan hanya soal memilih algoritma yang tepat, tetapi memastikan seluruh pipeline pengolahan data berjalan dengan benar.
Bagaimana Cara Mencegahnya?
- Pisahkan data sebelum preprocessing
Bagi data menjadi training dan testing terlebih dahulu. Parameter seperti scaler, encoder, dan imputer hanya dipelajari dari data training, lalu diterapkan ke data testing. - Perhatikan urutan waktu
Untuk data berbasis waktu, jangan gunakan informasi dari masa depan untuk memprediksi kondisi masa lalu. Urutan waktu harus tetap dipertahankan agar evaluasi mencerminkan kondisi nyata. - Periksa ketersediaan setiap fitur
Pastikan setiap fitur memang sudah tersedia ketika prediksi dibuat. Periksa kapan data dibuat, siapa yang mengisinya, dan apakah informasi tersebut berasal dari proses yang terjadi setelah target diprediksi. - Uji model dengan kondisi yang mendekati production
Jangan hanya mengandalkan performa pada dataset. Model perlu diuji menggunakan data dan skenario yang mendekati kondisi nyata karena performa tinggi di dataset belum tentu bertahan saat digunakan di dunia nyata.
Model Terbaik Bukan Selalu yang Akurasinya Tertinggi
Bayangkan ada dua model. Model A memiliki akurasi 98%, tetapi menggunakan informasi yang sebenarnya baru tersedia setelah kejadian. Sementara Model B hanya memiliki akurasi 89%, tetapi seluruh fiturnya benar-benar tersedia ketika prediksi dibuat. Secara angka, Model A memang terlihat lebih hebat. Namun untuk digunakan di dunia nyata, Model B justru lebih dapat dipercaya karena performanya diperoleh dari informasi yang valid.
Pada akhirnya, kualitas machine learning tidak hanya ditentukan oleh algoritma, jumlah data, atau seberapa tinggi akurasinya. Model yang baik adalah model yang belajar dari informasi yang memang boleh diketahuinya. Karena itu, sebelum mencari algoritma yang lebih kompleks, pastikan terlebih dahulu bahwa data yang digunakan tidak membuat model menyontek.
Penutup
Data leakage mengajarkan bahwa masalah terbesar dalam machine learning terkadang bukan terletak pada modelnya, melainkan pada data yang kita berikan kepada model tersebut. Prediksi yang terlihat sangat akurat bisa saja tidak berguna jika dibangun dari informasi yang seharusnya belum tersedia.
Dengan memahami konteks, waktu, dan proses di balik setiap data, kita dapat membangun model yang tidak hanya terlihat pintar di atas dataset, tetapi juga mampu bekerja secara masuk akal ketika diterapkan di dunia nyata.
Semoga artikel ini dapat membantu Sobat IT memahami pentingnya menjaga kualitas dan integritas data dalam membangun sistem machine learning yang benar-benar dapat diandalkan.